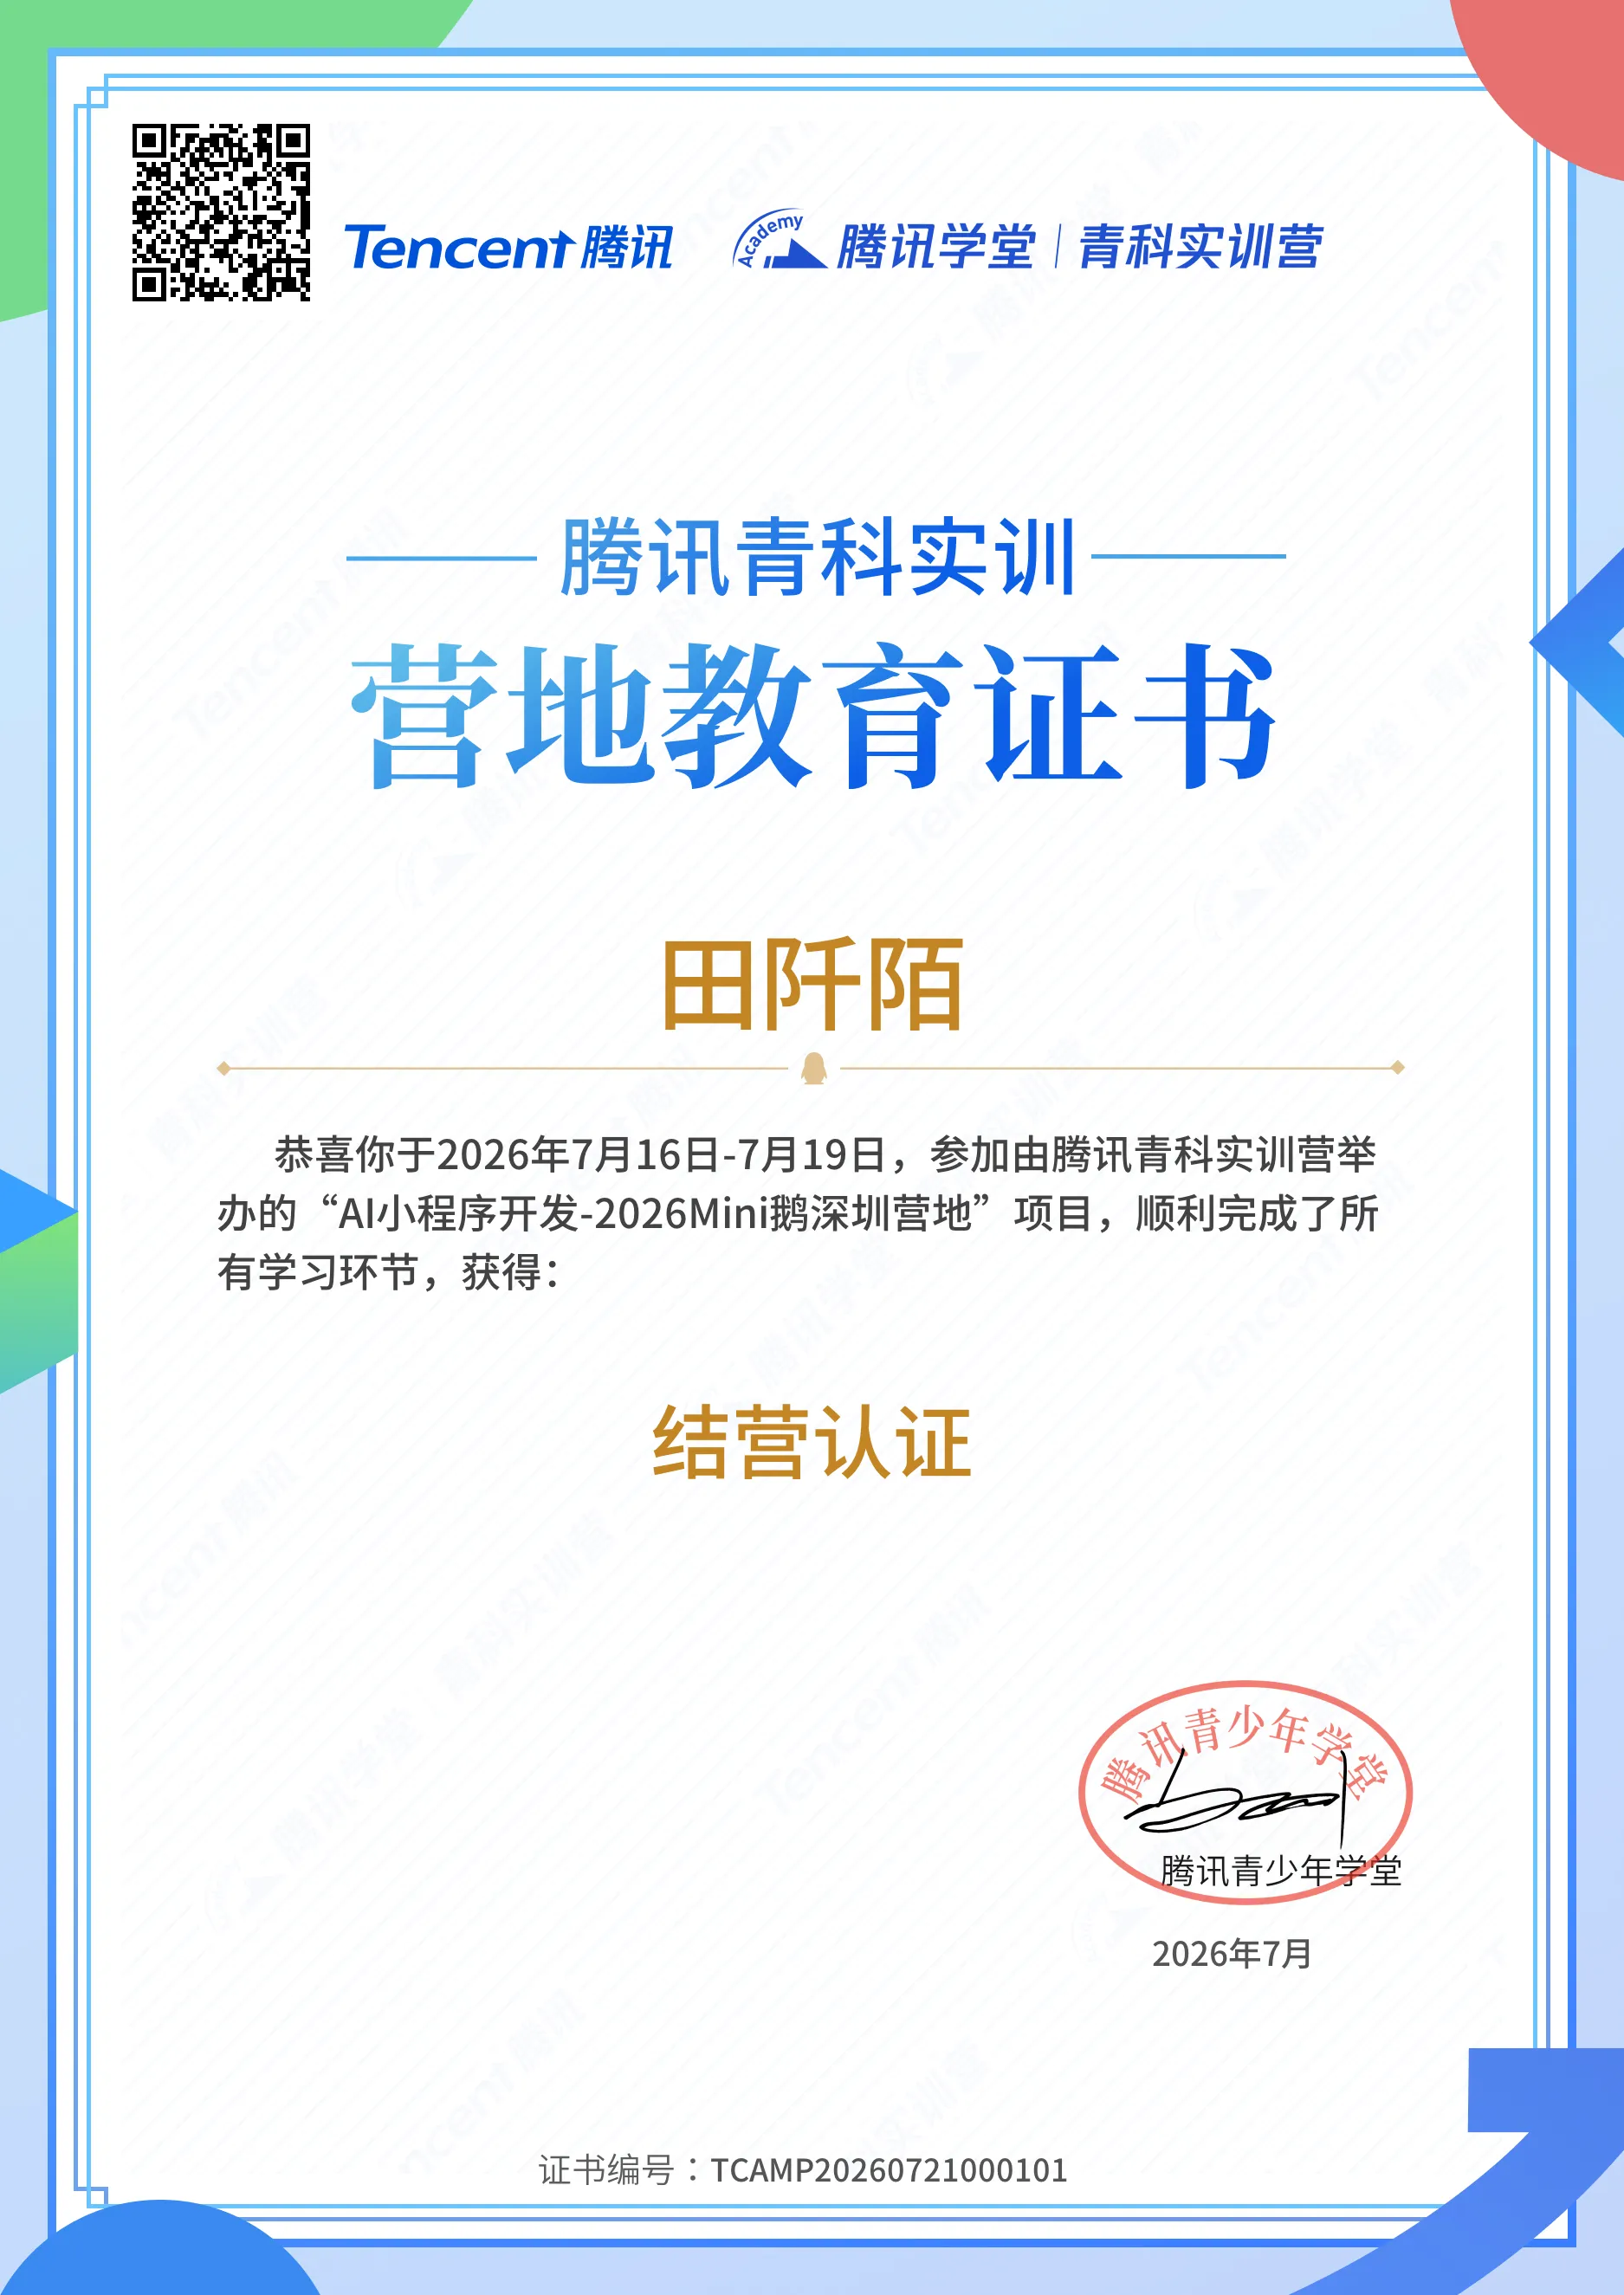
<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" xml:lang="en"><generator uri="https://jekyllrb.com/" version="4.4.1">Jekyll</generator><link href="https://43.128.89.193.nip.io/qianmo/feed.xml" rel="self" type="application/atom+xml"/><link href="https://43.128.89.193.nip.io/qianmo/" rel="alternate" type="text/html" hreflang="en"/><updated>2026-10-29T11:51:55+08:00</updated><id>https://43.128.89.193.nip.io/qianmo/feed.xml</id><title type="html">田阡陌</title><subtitle>16岁C++/AI全栈开发者。记录竞赛成绩、项目作品与技术成长。 </subtitle><entry><title type="html">从 HyperFrames 预演到 SenseVoice 对齐：一条三分钟短片的制作流水线</title><link href="https://43.128.89.193.nip.io/qianmo/blog/2026/shanjia-yuwu-pipeline/" rel="alternate" type="text/html" title="从 HyperFrames 预演到 SenseVoice 对齐：一条三分钟短片的制作流水线"/><published>2026-10-24T11:00:00+08:00</published><updated>2026-10-24T11:00:00+08:00</updated><id>https://43.128.89.193.nip.io/qianmo/blog/2026/shanjia-yuwu-pipeline</id><content type="html" xml:base="https://43.128.89.193.nip.io/qianmo/blog/2026/shanjia-yuwu-pipeline/"><![CDATA[<p>《善假于物》虽然是一部语文短片，但它的制作过程里用了一整套偏工程化的工具。这里把我实际用到的那条流水线整理出来。</p> <h2 id="hyperframes先跑通全片">HyperFrames：先跑通全片</h2> <p>在正式生成画面之前，我用 HyperFrames 做<strong>无配音全片预演</strong>。它用 HTML 组合和时间轴数据，把 18 个镜头的字幕、占位镜头和已有素材串成一条可从头播放的 200 秒预演。</p> <p>这一步的价值不在画面好看，而在于：不依赖人声，我也能判断结构、高潮、停顿和结尾是否成立。缺的镜头用明确的构图占位，不为了消灭灰板而提前生成。</p> <h2 id="ai-生图--生视频只在缺口处使用">AI 生图 / 生视频：只在缺口处使用</h2> <p>AI 画面只承担两类工作：一是<strong>关键帧</strong>（概念帧），用来定下“青出于蓝”“登高远眺”“舟行江面”这些意象的构图；二是<strong>短段生视频</strong>，为某些明确缺口补动态，比如染布的扩散、冰晶的形成。</p> <p>每段生成都记录镜头 ID、模型/版本、参考图、提示词、参数和候选号，方便追溯来源。</p> <h2 id="真人录音--本地-asr-对齐">真人录音 + 本地 ASR 对齐</h2> <p>声音是全片的叙事主线。我用本人原声录制整段旁白，然后用本地 <strong>SenseVoice</strong> 做语音识别，得到未经校订的全文和字级时间。</p> <p>接着按文稿对古文误识做规范化（比如“已／矣”“臂／比”、通假字“生”读 xìng），再用识别时间和校订文本做<strong>字符对齐</strong>，生成准确到字的字幕时间点。这样字幕不再靠人工逐字拍时间，节奏也更贴原声。</p> <h2 id="python-脚本--ffmpeg-合成">Python 脚本 + ffmpeg 合成</h2> <p>每个版本都有对应的构建脚本（<code class="language-plaintext highlighter-rouge">build_v2.py</code> 一路到 <code class="language-plaintext highlighter-rouge">build_v10.py</code>），负责读时间线、字幕、停顿和镜头位置，再用 ffmpeg 把片段按实际句子时间重新排布、编码。</p> <p>到 v10，整段原声处理后约 140 秒，加上片头片尾各三秒，全片 146 秒；1920×1080、25fps、AAC 48kHz，48 个画面片段按句子时间重新对齐。</p> <h2 id="交付">交付</h2> <p>最终导出 1080P 成片和封面，满足 MP4、16:9、≥1080p、≥25fps、≤200MB 的要求。整个流程里最省心的部分，是把“字幕、节奏、合成”这些重复劳动交给脚本和工具，把注意力留给真正需要判断的地方。</p> <p>如果你也在做 AI 视频，我的经验是：<strong>把可重复的步骤工程化，把不可重复的判断留给自己。</strong></p>]]></content><author><name></name></author><category term="技术笔记"/><category term="HyperFrames"/><category term="SenseVoice"/><category term="ASR"/><category term="视频制作"/><category term="技术"/><summary type="html"><![CDATA[记录《善假于物》制作中用到的技术栈：HyperFrames 做全片预演与字幕合成，本地 SenseVoice 做录音识别与字级对齐，Python 脚本串联渲染。]]></summary></entry><entry><title type="html">善假于物，不是停下学习：AI 时代我重新理解了“学习”</title><link href="https://43.128.89.193.nip.io/qianmo/blog/2026/shanjia-yuwu-ai-and-learning/" rel="alternate" type="text/html" title="善假于物，不是停下学习：AI 时代我重新理解了“学习”"/><published>2026-10-24T10:00:00+08:00</published><updated>2026-10-24T10:00:00+08:00</updated><id>https://43.128.89.193.nip.io/qianmo/blog/2026/shanjia-yuwu-ai-and-learning</id><content type="html" xml:base="https://43.128.89.193.nip.io/qianmo/blog/2026/shanjia-yuwu-ai-and-learning/"><![CDATA[<p>做这部短片之前，我对“学习”的理解其实有点模糊。做完了之后，我反而想清楚了一件事。</p> <h2 id="答案不等于理解">答案不等于理解</h2> <p>片子的开头是这样一句旁白：“有时候，答案来得太快了。一个问题输入屏幕，几秒钟后，我就能得到解释。可当我合上答案，试着用自己的话说清楚时，我还是会停下来。答案有了，我真的懂了吗？”</p> <p>这几乎就是我自己的真实体验。用 AI 查问题太方便了，方便到有时候我会误以为“看到了答案”就等于“学会了”。但真正让我停下来的是：关掉屏幕，让我自己讲一遍，我还是讲不利索。</p> <h2 id="工具与判断是两件事">工具与判断，是两件事</h2> <p>《劝学》里说“君子生非异也，善假于物也”，讲的是借助外物扩大自己的能力。我以前只记住了“善假于物”四个字，却容易漏掉它前面的那一层意思：借了车马、舟楫，不等于自己就会走路、会游泳。</p> <p>所以我把结尾落在这样一句上：<strong>“舟能帮我渡过江河，却不能替我选择方向。桨握在手里，我仍要观察水流，也要一次次调整。”</strong></p> <p>AI 能给我答案，甚至能帮我“看见更远的风景”，但理解、判断和修改，仍然要由我完成。工具负责“假物”，而我负责“善假”。</p> <h2 id="不把-ai-当敌人也不把关电脑当成长">不把 AI 当敌人，也不把关电脑当成长</h2> <p>做片子的过程中，我有意识地避开了两个极端。</p> <p>一个极端是把 AI 写成敌人，好像只要关掉电脑、回到纸笔，人就自然成长了。这不真实，也不诚实。电脑和课本完全可以同时摆在桌上。</p> <p>另一个极端是把“得到答案”当成终点，忘了后面还有理解、比较、删改和表达。</p> <p>我在结尾让主角既不关电脑，也不做夸张的顿悟，只是继续修改自己的句子。成长不是一次性的醒悟，而是“一次提问，一次比较，一次删改”这样一点点长出来的。</p> <h2 id="学习没有变得更简单">学习没有变得更简单</h2> <p>AI 时代，学习没有变得更简单，只是问题变了。以前的问题是“我能不能找到答案”，现在的问题更多是“我是不是真的懂了”“我该信哪一份答案”“我要怎么把它变成自己的表达”。</p> <p>这些问题，工具都替不了我。</p> <p>善假于物，不是停下学习，而是学会更好地出发。</p>]]></content><author><name></name></author><category term="成长"/><category term="AI"/><category term="学习"/><category term="思考"/><category term="成长"/><category term="劝学"/><summary type="html"><![CDATA[做《善假于物》的过程，本身就是一次对“学习”的重新理解：工具能带来答案，但理解、判断和修改，仍然要由自己完成。]]></summary></entry><entry><title type="html">声音先行、先全片后精镜：一个 AI 短片项目的制作方法论</title><link href="https://43.128.89.193.nip.io/qianmo/blog/2026/shanjia-yuwu-methodology/" rel="alternate" type="text/html" title="声音先行、先全片后精镜：一个 AI 短片项目的制作方法论"/><published>2026-10-24T09:00:00+08:00</published><updated>2026-10-24T09:00:00+08:00</updated><id>https://43.128.89.193.nip.io/qianmo/blog/2026/shanjia-yuwu-methodology</id><content type="html" xml:base="https://43.128.89.193.nip.io/qianmo/blog/2026/shanjia-yuwu-methodology/"><![CDATA[<p>《善假于物》做到一半的时候，我踩了一个很典型的坑：把最难、最贵的镜头先做了。</p> <h2 id="一开始的问题">一开始的问题</h2> <p>项目早期，我急着验证“舟楫渡河”这个高潮能不能做出来。渡河段涉及人物、水面、木舟、桨的动作和转场，是全片最容易出错的镜头。我在这里反复试了很多版，人物不一致、水面不真实、动作穿帮，一遍遍返工。</p> <p>结果很尴尬：局部样片堆了很多，整部片子却始终不能从头到尾看一遍，因为声音和结构都还没定。</p> <h2 id="一次重启">一次“重启”</h2> <p>后来我停下来，把整个项目“重启”了一遍，只定了四条硬规则：</p> <ol> <li><strong>先锁文案，后录配音</strong>。声音和全片结构没锁定之前，不做正式配音，更不投钱做付费生成。</li> <li><strong>先全片，后精镜</strong>。先做出能从头播放的低成本预演，再针对性地精修单个镜头。</li> <li><strong>每轮只解决一个问题</strong>。人物、物理动作、风格、节奏，不在同一轮里同时试错。</li> <li><strong>反馈集中收集</strong>。不逐镜零散返工，一次集中审片、一次性改完。</li> </ol> <p>这四条看起来平淡，但正是它们把项目从“局部很好、整片跑不通”救回到“能稳定交付”。</p> <h2 id="制作顺序">制作顺序</h2> <p>新的顺序是：文案 → 试读 → 锁镜头时间 → 静态分镜 → 高风险镜头测试 → 全片无配音预演 → 集中补拍 → 正式生成 → 精剪交付。</p> <p>其中最关键的是“无配音预演”：在没有任何配音的情况下，用字幕和占位镜头把 18 个镜头的节奏先跑通，确认高潮、停顿和结尾都成立，才进入下一步。</p> <h2 id="控制-ai-生成">控制 AI 生成</h2> <p>AI 生图、生视频是这套流程里最不可控的部分，所以我定了两条小规则：</p> <ul> <li><strong>一条生成只安排一个主要动作、一种运镜</strong>。复杂的正面说话、连续上船动作优先实拍或分切，不指望长段 AI 一次成功。</li> <li><strong>同一镜头最多连续试三轮</strong>。首轮验证、二轮修正、三轮还不行就简化动作或换镜头，不为一个复杂变形无限烧预算。</li> </ul> <h2 id="最想记住的一条">最想记住的一条</h2> <p>回想起来，这个项目教会我的不是某个工具的用法，而是<strong>生产顺序</strong>。先确认“要说什么”和“怎么讲完”，再去解决“某一个镜头怎么做得漂亮”。顺序对了，AI 才是帮手；顺序反了，AI 只会放大返工。</p> <p>如果你也在做 AI 视频，我的建议只有一句：先把整部片子跑通，再回来打磨最漂亮的那几秒。</p>]]></content><author><name></name></author><category term="技术笔记"/><category term="AI视频"/><category term="创作方法"/><category term="复盘"/><category term="项目管理"/><category term="声音先行"/><summary type="html"><![CDATA[复盘《善假于物》从“渡河样片反复返工”到“重启后 10 个版本交付”的转折，总结 AI 短片制作里最值得记住的四条硬规则。]]></summary></entry><entry><title type="html">《善假于物》：用 AI 把《劝学》拍成一部三分钟短片</title><link href="https://43.128.89.193.nip.io/qianmo/blog/2026/shanjia-yuwu-ai-film/" rel="alternate" type="text/html" title="《善假于物》：用 AI 把《劝学》拍成一部三分钟短片"/><published>2026-10-24T08:00:00+08:00</published><updated>2026-10-24T08:00:00+08:00</updated><id>https://43.128.89.193.nip.io/qianmo/blog/2026/shanjia-yuwu-ai-film</id><content type="html" xml:base="https://43.128.89.193.nip.io/qianmo/blog/2026/shanjia-yuwu-ai-film/"><![CDATA[<p>最近我做了一部只有三分钟的短片，叫《善假于物》。它不是为了炫技，而是为了回答一个一直绕在我心里的问题：当答案来得这么容易，我还需要怎样学习？</p> <h2 id="从劝学出发">从《劝学》出发</h2> <p>这个作品参加的是“典耀中华·课本里的中国”语文 AI 创作展示活动。我选了荀子的《劝学》，只用一个主文本，不把别的课文拼进来。方向落在最后一句——<strong>“君子生非异也，善假于物也”</strong>。</p> <p>我没有把它拍成“AI 有多厉害”的宣传片，而是想讲一个更具体的故事：一个学生得到了现成的答案，却发现自己还是说不清楚，于是通过朗读、想象、比较和修改，慢慢把答案变成自己的理解。</p> <h2 id="六段结构">六段结构</h2> <p>整部片子按旁白分成六段，共 18 个镜头：</p> <ol> <li><strong>答案与理解</strong>——现实书桌，提出“答案不等于理解”。</li> <li><strong>学习使人改变</strong>——“学不可以已”“青出于蓝”“水凝成冰”。</li> <li><strong>从思考到看见</strong>——“终日而思”走向“登高博见”。</li> <li><strong>舟楫渡河</strong>——“假舟楫者”，这是全片唯一的视觉高潮。</li> <li><strong>积累与判断</strong>——“不积跬步”，回到删改、重写的具体动作。</li> <li><strong>回到当下</strong>——电脑和课本并置，继续修改自己的表达。</li> </ol> <p>最终成片大约 146 秒，1920×1080、25fps。镜头顺序和文案都锁定以后，我才录自己的原声旁白。</p> <h2 id="真人声音--ai-意象">真人声音 + AI 意象</h2> <p>这部片子最重要的决定，是<strong>让真人声音当叙事主体，AI 影像只负责难以实拍的空间和意象</strong>。</p> <p>书桌、翻页、握笔这些镜头用实拍或占位；而“青出于蓝”的布纹扩散、“水凝成冰”的纹理、“登高远眺”的开阔河谷，这些用 AI 生成的关键帧和短段视频来表现。清晰可读的古文字幕由后期排字完成，不交给视频模型去“画字”。</p> <h2 id="现在的状态">现在的状态</h2> <p>项目从 v1 迭代到 v10，中间经历过一次“重启”——我一度把大量时间投在最难的渡河段，结果局部样片迭代很多，整片却始终无法从头播放。后来我回到“先锁文案、先全片后精镜”的顺序，才一步步走到可交付的版本。</p> <p>到今天，v10 已经导出 1080P 成片和封面，放在交付文件夹里。距离正式提交还有一点时间，接下来主要是按官方要求做最后的参数核对和逐字校对。</p> <p>这部片子让我重新读了一遍《劝学》，也让我更清楚地看到：工具能把我送到更远的地方，但掌舵的仍然是自己。</p>]]></content><author><name></name></author><category term="实践记录"/><category term="AI"/><category term="视频创作"/><category term="善假于物"/><category term="劝学"/><category term="语文"/><category term="成长"/><summary type="html"><![CDATA[复盘为“典耀中华·课本里的中国”语文 AI 创作活动制作的短片：从《劝学》出发，用真人原声与 AI 意象回答“答案有了，我真的懂了吗”。]]></summary></entry><entry><title type="html">北京 AI 工作生活总结：从等待任务，到主动解决问题</title><link href="https://43.128.89.193.nip.io/qianmo/blog/2026/beijing-ai-work-life-summary/" rel="alternate" type="text/html" title="北京 AI 工作生活总结：从等待任务，到主动解决问题"/><published>2026-08-11T00:00:00+08:00</published><updated>2026-08-11T00:00:00+08:00</updated><id>https://43.128.89.193.nip.io/qianmo/blog/2026/beijing-ai-work-life-summary</id><content type="html" xml:base="https://43.128.89.193.nip.io/qianmo/blog/2026/beijing-ai-work-life-summary/"><![CDATA[<p>来到北京之前，我对这座城市有很多想象：密集的科技公司、忙碌的程序员、随处可见的新鲜事物，以及真正参与 AI 项目开发的兴奋感。但真正住下来以后，我最直接的生活感受却是——北京好像有点无聊。</p> <p>每天往返于住处和公司，看到的是高楼、地铁和匆匆赶路的人群。下班后也没有太多特别想去的地方，城市似乎没有想象中那么鲜明。不过，正是在这种略显单调的生活中，我第一次真正接触企业研发，也第一次发现，工作的“新鲜”并不来自每天都有好玩的事情，而是来自不断遇到自己不会的问题，再想办法把它解决。</p> <p>这三周里，我主要参与智能翻译 Agent 的开发。</p> <h2 id="第一周适应真实的研发环境">第一周：适应真实的研发环境</h2> <p>刚进入公司，我先完成了堡垒机、Token、权限申请等开发环境配置。以前自己写项目时，打开电脑就可以直接开始，但企业项目需要经过权限、流程和协作环节。因为部分权限没有及时开通，我一开始无法正常接入。后来通过主动询问和沟通，问题才得到解决。</p> <p>这一周，我也开始熟悉智能翻译项目以及公司的组织结构。刚接触项目时，代码、内部工具和协作方式都比较陌生，需要先理解每个模块负责什么，再判断自己能够从哪里开始。第一周让我意识到，真实研发并不只是写代码。环境配置、权限管理、沟通反馈和团队协作，都是工作的一部分。</p> <h2 id="第二周从开源框架走向真正落地">第二周：从开源框架走向真正落地</h2> <p>第二周，我开始真正参与功能开发。为了更快理解智能翻译 Agent 的实现方式，我参考了 GitHub 上的开源项目，并下载了一个基础框架。但这个框架并不能直接照搬。它原本依赖本地数据库，而我们的项目需要运行在浏览器环境中，所以我必须重新设计数据存储方式。</p> <p>最终，我使用浏览器本地存储实现用户记忆，保存用户选择的语言、学习水平和最近的会话历史。同时，我将 Skill 改为按需加载，增加空数据降级、请求重试和多搜索源适配。即使部分服务暂时不可用，基础翻译功能也能继续运行。</p> <p>在这个基础上，我还搭建了支持文本、图片、音频和文档输入的多模态 Web Demo，并逐渐建立统一的输入规范、模块注册和结果组装流程。翻译不再只是输入一句话、输出一句话，而是可以结合用户背景、历史记录和具体情境，选择不同的功能模块。</p> <p>这让我明白，开源项目提供的是起点和思路，而不是标准答案。真正的工程开发，需要理解为什么这样设计，再根据自己的运行环境、产品目标和失败场景重新实现。把项目下载下来并不难，难的是把它变成真正适合当前需求的系统。</p> <h2 id="第三周重构验证与表达">第三周：重构、验证与表达</h2> <p>第三周，我的工作从增加功能转向架构、测试和技术表达。我继续优化模块边界，加入缓存、懒加载、错误恢复、历史回溯和批量导入，并逐步完善多个输出模块的契约、提示词和评测样例。项目测试数量增加到 132 项并全部通过，部分请求的响应时间也得到了明显改善。</p> <p>这一周，我还准备了工作汇报和工程问题分享。最初，我习惯把大量代码和技术细节放进 PPT，以为内容越多越能证明自己做得深入。但实际效果并不好：别人很难在短时间内抓住重点。</p> <p>后来，我把复杂代码改成流程图、状态图和生活化类比，重点说明问题是什么、为什么发生、如何解决。这个过程让我认识到，技术做得再深，如果不能让别人听懂，就很难真正产生价值。工程师不仅要会实现，也要能清楚表达自己的判断。</p> <h2 id="从等待安排到主动推进">从等待安排到主动推进</h2> <p>这三周给我最大的改变，是开始理解工作与学习的不同。</p> <p>在学校里，课程表会告诉我今天学什么，老师会布置作业，考试会给出明确范围。但在工作中，很少有人不断提醒“你下一步应该做什么”。当任务不明确时，需要自己梳理；遇到阻塞时，需要主动沟通；完成一个功能后，还要自己考虑是否存在边界问题、如何验证，以及下一步还能改进什么。</p> <p>刚来之前，我以为进入企业项目的人应该都非常厉害，很多问题可能只有我不会。真正相处以后，我发现大家也会遇到不了解的技术，也需要查资料、讨论和反复尝试。同学之间的实际差距并没有我想象中那么神秘。真正重要的不是谁从来不犯错，而是谁能够更主动地开始、更快地找到问题，并愿意持续把事情做完。</p> <p>北京的生活也许没有想象中热闹，实习工作也没有想象中神秘。大多数时候，只是坐在屏幕前阅读代码、修改功能、排查问题，再一次次验证结果。但这种平静的重复，让我开始从“等待别人安排任务”，慢慢走向“主动发现下一步”。</p> <p>如果要用几个词总结这三周，我会选择：<strong>适应、落地、重构和表达</strong>。</p> <p>北京依然有些无聊，但这个夏天并不单调。城市的特色未必只藏在景点和高楼里，也可能藏在深夜仍然亮着的屏幕、一次次被修复的错误，以及一个高中生第一次真正参与 AI 项目时，逐渐建立起来的判断力和责任感。</p>]]></content><author><name></name></author><category term="实习记录"/><category term="网易实习"/><category term="AI翻译"/><category term="Agent"/><category term="北京"/><category term="成长"/><summary type="html"><![CDATA[总结在北京参与智能翻译 Agent 开发三周的工作经历，以及从校园学习走向真实工程实践后的思考。]]></summary></entry><entry><title type="html">网易实习第三周：技术做得再深，讲不清楚等于没做</title><link href="https://43.128.89.193.nip.io/qianmo/blog/2026/netease-internship-week-3/" rel="alternate" type="text/html" title="网易实习第三周：技术做得再深，讲不清楚等于没做"/><published>2026-08-02T00:00:00+08:00</published><updated>2026-08-02T00:00:00+08:00</updated><id>https://43.128.89.193.nip.io/qianmo/blog/2026/netease-internship-week-3</id><content type="html" xml:base="https://43.128.89.193.nip.io/qianmo/blog/2026/netease-internship-week-3/"><![CDATA[<p>实习第三周，我的工作从单点功能开发进一步转向架构、测试和工程表达。除了继续改进翻译助手，我还要把做过的事情、遇到的问题和背后的思考讲给别人听。</p> <h2 id="本周完成">本周完成</h2> <h3 id="1-完成-trans_agent-demo-v110-系统改进">1. 完成 trans_agent-demo v1.1.0 系统改进</h3> <ul> <li>使用 ESLint 和 Prettier 统一代码规范，将 lint 告警清零。</li> <li>加入请求缓存与懒加载，响应时间降低约 40%。</li> <li>增加错误恢复、翻译历史回溯和批量导入功能。</li> <li>重构模块边界，降低模块之间的耦合。</li> </ul> <h3 id="2-完善测试安全与-skill-工具">2. 完善测试、安全与 Skill 工具</h3> <ul> <li>搭建由 8 个测试文件和分析报告组成的测试体系。</li> <li>完善评分系统中的 PBKDF2 与 AES-GCM 加密流程。</li> <li>开发由 3 个模块组成的 Skills 导出工具，整理 34 个 Skill 定义。</li> <li>完成七个输出模块的第一层实现，并为不同模块补齐契约、Prompt、评测脚本和语义样例。</li> <li>测试数量由 119 项增加到 132 项并全部通过。</li> </ul> <h3 id="3-准备工作汇报与工程问题分享">3. 准备工作汇报与工程问题分享</h3> <ul> <li>完成 10 页工作汇报答辩 PPT，并使用 Ardot 画布完成版面设计。</li> <li>制作水墨动画 HTML 演示稿。</li> <li>完成 9 页工程问题分享稿，分析“反馈按钮互斥”和“重试上下文丢失”两个 Bug 的根因与修复方案。</li> </ul> <h2 id="遇到的问题及解决方式">遇到的问题及解决方式</h2> <p>第一个问题是 Ardot 画布不支持动画。我没有放弃原来的视觉想法，而是改用 HTML 和 Canvas，实现水墨冲刷式的翻页效果。</p> <p>第二个问题是工程分享稿第一版塞入了太多代码。虽然技术细节完整，但别人很难迅速理解。第二轮修改时，我把大段代码换成 SVG 图解和生活化类比，让问题的状态变化、根因和修复逻辑更直观。</p> <h2 id="两个-bug-带来的思考">两个 Bug 带来的思考</h2> <p>“反馈按钮互斥”和“重试上下文丢失”表面上并不相关，但继续向下分析后，我发现它们有相同的根因：<strong>把界面表现误当成了系统状态的唯一来源。</strong></p> <p>界面会重新渲染，局部数据也可能丢失。真正可靠的状态应该被明确建模和管理，而不是从按钮是否高亮、页面当前显示什么反向推断。</p> <p>这让我体会到，修复 Bug 不能只盯着出问题的那一行代码。找到共同根因，才能避免同类问题再次出现。</p> <h2 id="下周计划">下周计划</h2> <ol> <li>根据答辩反馈继续修改和完善 PPT。</li> <li>跟进 v1.1.0 后续改进项。</li> <li>继续迭代产品规格文档和模块化架构。</li> <li>持续验证模型路由、多模块组合和边界场景表现。</li> </ol> <h2 id="本周收获与感想">本周收获与感想</h2> <p>这一周，我不仅更理解了状态管理、模块解耦和测试体系，也重新认识了技术表达。</p> <p>图比大段文字更容易理解，大白话比堆砌术语更有效。技术做得再深，如果不能让团队理解它解决了什么问题、为什么这样设计，就很难真正产生价值。</p> <p>第三周的关键词是：<strong>重构、验证、表达</strong>。</p>]]></content><author><name></name></author><category term="实习记录"/><category term="网易实习"/><category term="AI翻译"/><category term="软件工程"/><category term="技术表达"/><category term="周报"/><summary type="html"><![CDATA[完成翻译助手架构、性能和测试升级，并在答辩准备中重新理解技术表达的重要性。]]></summary></entry><entry><title type="html">网易实习第二周：让 AI 翻译助手真正记住用户</title><link href="https://43.128.89.193.nip.io/qianmo/blog/2026/netease-internship-week-2/" rel="alternate" type="text/html" title="网易实习第二周：让 AI 翻译助手真正记住用户"/><published>2026-07-26T00:00:00+08:00</published><updated>2026-07-26T00:00:00+08:00</updated><id>https://43.128.89.193.nip.io/qianmo/blog/2026/netease-internship-week-2</id><content type="html" xml:base="https://43.128.89.193.nip.io/qianmo/blog/2026/netease-internship-week-2/"><![CDATA[<p>进入实习第二周，我开始从“熟悉项目”走向真正的功能开发。这一周的重点，是让 AI 翻译助手不只完成一次翻译，而是逐渐具备记忆、情境理解和持续改进的能力。</p> <h2 id="本周完成">本周完成</h2> <ol> <li><strong>加入用户记忆功能</strong>：保存用户选择的语言和学习水平，下次打开时不必重新设置；同时支持空白草稿、会话复制和最近 8 条历史压缩。</li> <li><strong>调整 Skill 调用方式</strong>：将技能改为按需、分层加载，减少不必要的调用，让系统更容易扩展。</li> <li><strong>标准化 Skill 文档</strong>：打通批量导出、导入和自动去重流程，为后续统一维护技能体系打下基础。</li> <li><strong>接入自我学习机制</strong>：用户反馈可以进入改进流程，帮助系统发现未命中场景并持续完善。</li> <li><strong>增加情境提醒</strong>：根据天气、位置和附近门店提供建议，并优先使用免费接口。</li> <li><strong>搭建可运行的多模态 Web Demo</strong>：支持文本、图片、音频和文档输入，建立 11 个场景级 Skill，并验证翻译路由能够正确命中。</li> <li><strong>启动 v0.2 框架基线</strong>：建立统一输入、模块注册、执行计划和结果组装规范，让翻译与功能规划可以并行执行，并对单个模块失败进行隔离。</li> </ol> <h2 id="遇到的问题及解决方式">遇到的问题及解决方式</h2> <p>参考的开源方案依赖本地数据库，但项目需要直接运行在浏览器环境中，无法照搬。</p> <p>我最终改用浏览器自带的本地存储，并增加空数据自动降级机制。即使历史数据不存在或读取失败，原有翻译功能也能继续使用。同时，针对模型和搜索服务的不稳定，我补充了递增重试、多搜索源适配和安全降级策略。</p> <p>这次经历让我更加理解：开源方案提供的是思路，不是可以不加判断直接复制的答案。真正的工程实现，需要结合运行环境、产品目标和失败场景重新设计。</p> <h2 id="下周计划">下周计划</h2> <ol> <li>拆分过大的核心文件，按模块重构，提高可读性和维护效率。</li> <li>让能够独立执行的子任务并行运行，缩短整体响应时间。</li> <li>补充更多边界场景测试，提高意图识别和模块选择的准确率。</li> <li>继续完善模块输出、去重规则和回归评测。</li> </ol> <h2 id="本周收获与感想">本周收获与感想</h2> <p>这一周，我没有硬搬任何一套开源方案，而是把每个值得借鉴的部分结合浏览器环境改造后再使用。</p> <p>如果说第一周学到的是“遇到阻塞要及时沟通”，那么第二周学到的就是：<strong>能跑起来只是开始，能够在限制条件下稳定运行，才是真正的工程能力。</strong></p> <p>第二周的关键词是：<strong>落地、适配、降级</strong>。</p>]]></content><author><name></name></author><category term="实习记录"/><category term="网易实习"/><category term="AI翻译"/><category term="Agent"/><category term="全栈开发"/><category term="周报"/><summary type="html"><![CDATA[从浏览器端记忆、按需加载到自我改进机制，记录 AI 翻译项目从想法走向可运行 Demo 的一周。]]></summary></entry><entry><title type="html">腾讯 Mini鹅深圳营地：四天 AI 小程序开发实践</title><link href="https://43.128.89.193.nip.io/qianmo/blog/2026/tencent-mini-goose-shenzhen-camp/" rel="alternate" type="text/html" title="腾讯 Mini鹅深圳营地：四天 AI 小程序开发实践"/><published>2026-07-20T00:00:00+08:00</published><updated>2026-07-20T00:00:00+08:00</updated><id>https://43.128.89.193.nip.io/qianmo/blog/2026/tencent-mini-goose-shenzhen-camp</id><content type="html" xml:base="https://43.128.89.193.nip.io/qianmo/blog/2026/tencent-mini-goose-shenzhen-camp/"><![CDATA[<p>2026 年 7 月 16 日至 19 日，我参加了腾讯青科实训营举办的 <strong>“AI 小程序开发—2026 Mini鹅深圳营地”</strong>，完成全部学习环节并获得结营认证。</p> <p>对我来说，这不仅是一张证书，更是一次走进企业技术实践场景、了解 AI 与小程序开发结合方式的难得机会。</p> <figure style="max-width: 680px; margin: 2rem auto;"> <a href="/qianmo/assets/img/achievements/tencent-mini-goose-shenzhen-2026.png" target="_blank" rel="noopener noreferrer"> <img src="/qianmo/assets/img/achievements/tencent-mini-goose-shenzhen-2026.png" alt="腾讯青科实训营 AI 小程序开发 2026 Mini鹅深圳营地结营证书" loading="lazy" style="width: 100%; border-radius: 0.75rem;"/> </a> <figcaption style="margin-top: 0.75rem; text-align: center;"> 腾讯青科实训营“AI 小程序开发—2026 Mini鹅深圳营地”结营认证 </figcaption> </figure> <h2 id="从学习技术到完成项目">从“学习技术”到“完成项目”</h2> <p>在学校和日常训练中，我接触得更多的是编程语言、算法题和个人项目。参加营地后，我更加关注一个完整应用是怎样从想法走到实现的：不仅要考虑技术能不能完成，还要考虑功能是否真正解决问题、用户是否能顺利使用，以及作品能否被清楚地展示出来。</p> <p>AI 小程序开发把两个我非常感兴趣的方向连接在了一起：一边是人工智能能力，另一边是离真实用户很近的小程序应用。技术只有被放入具体场景，才会从“会使用的工具”变成“能够解决问题的产品”。</p> <h2 id="四天带来的改变">四天带来的改变</h2> <p>四天时间并不长，但集中式实践让我再次感受到，学习效率不仅取决于掌握了多少知识点，还取决于能不能快速理解任务、拆解问题并完成交付。</p> <p>这段经历也让我更明确了接下来的学习方向：</p> <ol> <li>继续提高把 AI 能力落地为真实产品的能力。</li> <li>不只关注功能实现，也要关注用户体验和应用场景。</li> <li>学会在有限时间内判断优先级，先完成可用版本，再持续迭代。</li> <li>通过复盘和输出，把短期活动中的经验沉淀为长期能力。</li> </ol> <h2 id="一次企业实践也是一份荣誉">一次企业实践，也是一份荣誉</h2> <p>这次结营认证代表我完成了营地设置的全部学习环节，但它不是终点。真正重要的是把营地里形成的产品意识、实践方法和解决问题的习惯，带回到之后的 AI 项目与学习中。</p> <p>从腾讯 Mini鹅深圳营地，到之后参与更真实的 AI 项目开发，我正在逐渐从“喜欢编程”走向“尝试用技术做出真正有价值的东西”。</p> <p>项目详情可以访问：<a href="https://tcamp.qq.com/">腾讯营地官网</a>。</p> <p>这次经历的关键词是：<strong>实践、产品、成长</strong>。</p>]]></content><author><name></name></author><category term="实践记录"/><category term="腾讯"/><category term="青科实训营"/><category term="AI小程序"/><category term="Mini鹅"/><category term="成长"/><summary type="html"><![CDATA[记录参加腾讯青科实训营“AI 小程序开发—2026 Mini鹅深圳营地”并获得结营认证的成长经历。]]></summary></entry><entry><title type="html">网易实习第一周：从熟悉环境到接手 AI 翻译项目</title><link href="https://43.128.89.193.nip.io/qianmo/blog/2026/netease-internship-week-1/" rel="alternate" type="text/html" title="网易实习第一周：从熟悉环境到接手 AI 翻译项目"/><published>2026-07-19T00:00:00+08:00</published><updated>2026-07-19T00:00:00+08:00</updated><id>https://43.128.89.193.nip.io/qianmo/blog/2026/netease-internship-week-1</id><content type="html" xml:base="https://43.128.89.193.nip.io/qianmo/blog/2026/netease-internship-week-1/"><![CDATA[<p>这是我在网易实习的第一周。对我来说，这一周既是进入真实研发环境的起点，也是一次从校园学习走向工程实践的适应过程。</p> <h2 id="本周完成">本周完成</h2> <ol> <li>完成堡垒机接入配置。</li> <li>完成 Token 接入与相关权限申请。</li> <li>初步接手并熟悉 AI 翻译项目。</li> <li>了解公司的组织架构以及不同职位的职责定位。</li> </ol> <h2 id="遇到的问题及解决方式">遇到的问题及解决方式</h2> <p>在配置堡垒机和 Token 时，因为权限尚未开通，暂时无法正常接入。</p> <p>发现问题后，我及时向老师反馈，并在老师的协助下完成了权限开通。这个过程让我更加清楚：进入真实的企业研发环境后，除了写代码，还需要熟悉权限、协作和内部流程；遇到阻塞时，也要及时沟通，避免问题长时间停留。</p> <h2 id="下周计划">下周计划</h2> <ol> <li>深入理解并完善 AI 翻译项目的功能开发。</li> <li>将项目部署、上传至堡垒机。</li> </ol> <h2 id="本周收获与感想">本周收获与感想</h2> <p>入职一周，老师带我们快速了解了公司的组织架构和各岗位的职责定位。在实际操作中，我遇到了权限接入问题，也逐渐开始熟悉企业项目的工作方式。</p> <p>这一周也让我意识到，自己在技术细节上还有不少欠缺。接下来要加快学习节奏——<strong>菜就多练</strong>，争取早日具备独立承担模块开发的能力。</p> <h2 id="自媒体更新">自媒体更新</h2> <p>在完成实习适应和项目学习的同时，我也继续更新自己的自媒体，记录这段从竞赛训练、AI 开发走向真实企业研发的成长经历。输出不仅是分享，也是一次重新整理和复盘。</p> <p>第一周的关键词是：<strong>适应、沟通、学习</strong>。下一周，继续向真正的项目开发迈进一步。</p>]]></content><author><name></name></author><category term="实习记录"/><category term="网易实习"/><category term="AI翻译"/><category term="成长"/><category term="周报"/><summary type="html"><![CDATA[记录入职网易第一周的工作进展、问题处理、成长感受与下一步计划。]]></summary></entry><entry><title type="html">16岁，你好：我的第一个全栈AI项目复盘</title><link href="https://43.128.89.193.nip.io/qianmo/blog/2026/hello-16/" rel="alternate" type="text/html" title="16岁，你好：我的第一个全栈AI项目复盘"/><published>2026-07-03T18:00:00+08:00</published><updated>2026-07-03T18:00:00+08:00</updated><id>https://43.128.89.193.nip.io/qianmo/blog/2026/hello-16</id><content type="html" xml:base="https://43.128.89.193.nip.io/qianmo/blog/2026/hello-16/"><![CDATA[<h1 id="缘起">缘起</h1> <p>不知不觉已经 16 岁了。回想过去的一年，最让我有成就感的事情，莫过于完成了那个 <strong>基于计算机视觉的智能环保分类垃圾桶</strong> 项目。</p> <p>起初，我只是想在桌面上放一个能“自动张嘴”的垃圾桶，觉得这样很酷。但随着想法的深入，我开始思考：既然学了 Python 和 AI 相关的知识，为什么不让它变得更聪明一点呢？于是，这个全栈 AI 项目的构思就诞生了。</p> <h1 id="踩坑与挑战">踩坑与挑战</h1> <h2 id="1-算力瓶颈与模型轻量化">1. 算力瓶颈与模型轻量化</h2> <p>刚开始，我直接套用了 ResNet50，结果在树莓派上跑起来简直是灾难——一秒钟一帧都不到。看着垃圾桶迟钝的反应，我意识到在端侧部署 AI 并不是简单的 API 调用。 后来，我查阅了大量资料，尝试使用了 MobileNetV2，并进行了模型量化（Quantization），最终把推理速度提升到了可接受的范围。</p> <h2 id="2-c-与-python-的混合双打">2. C++ 与 Python 的混合双打</h2> <p>为了榨干硬件的最后一丝性能，我决定用 C++ 来重写视频流的拉取和硬件控制模块，而 Python 则专注于 AI 推理。如何让这两种语言高效通信？</p> <ul> <li>尝试过 Socket 通信，但延迟不稳定。</li> <li>最后使用了共享内存（Shared Memory）和本地 C++ 扩展（Pybind11）的方式，完美解决了数据传递的瓶颈。</li> </ul> <h1 id="收获">收获</h1> <p>当你写下的代码能够控制物理世界的机械臂，当你训练的模型能够准确认出一个塑料瓶，那种感觉是纯粹的软件开发无法比拟的。</p> <p>16 岁这一年，我不再满足于做算法题（虽然 NOIP 还是得继续卷 😂），我开始渴望构建真正的、有用的系统。</p> <p>继续前行吧，向着改变世界的那一行代码！🚀</p>]]></content><author><name></name></author><category term="技术笔记"/><category term="AI"/><category term="C++"/><category term="成长"/><summary type="html"><![CDATA[记录了开发智能环保分类垃圾桶的心路历程]]></summary></entry></feed>